Una de las confusiones más comunes hoy es pensar que implementar “IA” significa conectar un API de OpenAI, Anthropic, Google o cualquier otro proveedor.
Pero eso es como decir que construir una empresa digital es “tener una página web”.
Técnicamente puede ser parte del sistema. Pero no es el sistema. Para explicar esto, usemos un ejemplo: radiología.
No porque este sea un artículo para radiólogos; no lo es. Lo usamos porque radiología muestra muy bien algo que se aplica a casi cualquier industria: manufactura, retail, finanzas, gobierno o logística.
Esto es, que la pregunta que cualquier equipo en estos sectores debe hacerse es:
¿Qué tipo de problema estamos resolviendo, con qué tipo de datos, con qué nivel de riesgo y con qué arquitectura?
No todos los problemas de IA son problemas de lenguaje, y no todos los problemas de lenguaje se resuelven solo con un LLM.
Radiología como ejemplo
Desde afuera, puede parecer simple automatizar el flujo de trabajo de un radiólogo:
- Llega una radiografía.
- Alguien la mira.
- Escribe un reporte.
Hasta Geoffrey Hinton, uno de los investigadores con más renombre en el campo de la inteligencia artificial, ganador del Premio Nobel de Física y del Premio Turing, predijo que no tenía sentido seguir entrenando más radiólogos: su trabajo sería automatizado.
Así que sería fácil pensar, para cualquiera de nosotros:
“Perfecto, le pasamos la imagen a un modelo de OpenAI y que escriba un reporte.”
El primer problema es que no se mapeó el flujo real, y por tonto que parezca, esto es algo tan fácil de hacer como de no hacer: tener claro el flujo de inicio a fin.
El flujo real de un radiólogo se ve más o menos así:
Orden médica→Imagen médica→Revisión del radiólogo→Comparación con estudios previos→Dictado del reporte→Edición→Firma
El segundo problema es no entender los tipos de datos de entrada y salida.
- Una radiografía, una tomografía o una resonancia no son solo “imágenes”, son datos médicos especializados.
- Y el reporte de salida no es solo “texto”. Es un documento clínico que puede influir en una decisión médica real.
Un sistema de IA no puede limitarse a sonar inteligente.
- Tiene que ser correcto.
- Tiene que ser verificable.
- Tiene que saber cuándo no responder.
El tercer problema es que muchos estamos confundiendo automatizar tareas con automatizar trabajos y responsabilidades.
- El trabajo del radiólogo es atención al paciente, y una de las tareas de su trabajo es generar reportes.
- Además, cada reporte conlleva una responsabilidad. Si el reporte dice puras cosas locas, el radiólogo será el responsable.
Dudamos que la mayoría le delegáramos en su totalidad, sin darle un ojo, nuestra salud, contabilidad o finanzas a un modelo que pueda alucinar.
En radiología lo interesante es que no desapareció el trabajo. En muchos sistemas de salud pasó casi lo contrario: aumentó el volumen de estudios, aumentó la presión operativa y el rol del radiólogo siguió siendo necesario.
El rol de muchos sistemas robustos hoy es automatizar tareas, pero no reemplaza la responsabilidad.
Cómo se podría ver el uso de un LLM en un modelo predictivo de radiología
Hay varias arquitecturas posibles, dependiendo de qué problema quieres resolver.
Aquí va una de las que está usando una startup que compite contra los modelos MAIRA de Microsoft y Gemma de Google.
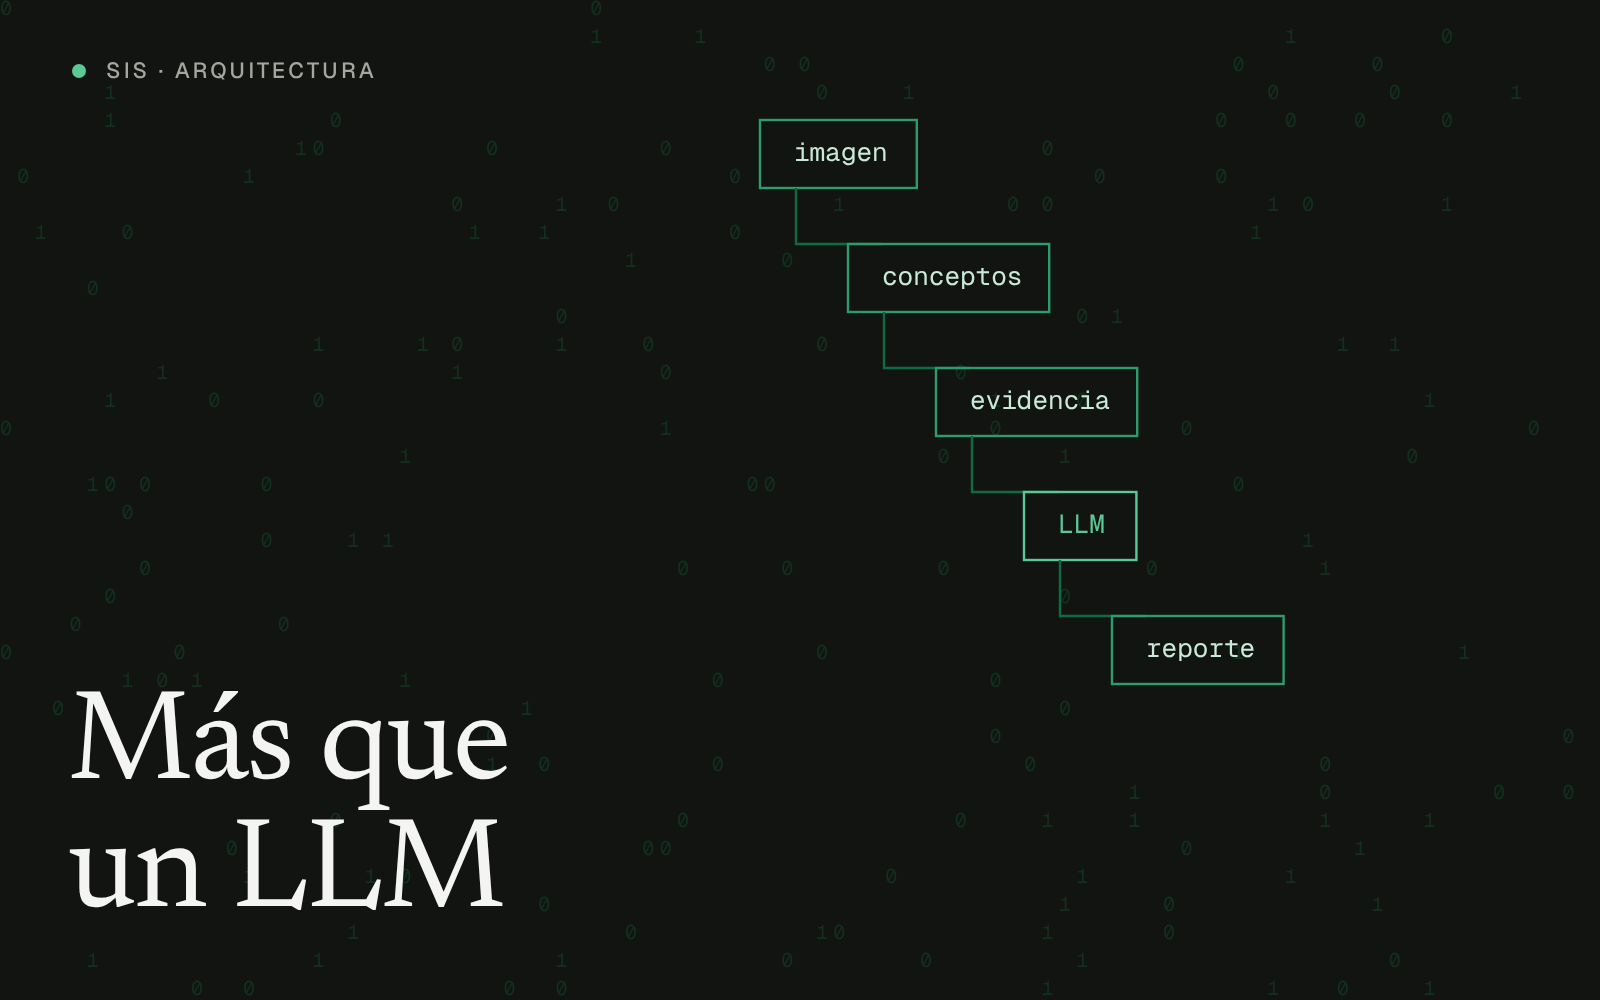
Conceptos, evidencia y un LLM controlado
En esta arquitectura, en vez de dejar que el LLM genere libremente el reporte:
- El sistema primero extrae conceptos clínicos de la imagen.
- Luego conecta esos conceptos con evidencia visual.
- Y después usa un modelo de lenguaje para redactar, pero bajo restricciones.
Algo así:
Imagen→Conceptos clínicos→Evidencia→Generación controlada→Reporte verificable
Esta arquitectura intenta separar mejor los roles.
- El modelo de visión identifica señales.
- El SAE crea una capa de evidencia.
- El LLM ayuda a redactar.
- El humano revisa y firma.
SAE significa Sparse Autoencoder. A nivel simple, es un modelo que intenta encontrar patrones internos más interpretables dentro de las representaciones que ya produjo un modelo de visión.
La parte de “sparse” importa porque el sistema intenta activar pocas señales relevantes a la vez, no una mezcla enorme difícil de entender. Eso permite que algunas features se puedan asociar con conceptos clínicos como derrame pleural, cardiomegalia o presencia de marcapasos.
Entonces el LLM no está escribiendo desde cero. Está redactando sobre señales que otro modelo extrajo antes de la imagen.
El reto es que esta arquitectura también es más compleja, porque necesitarás:
- Verificar que la evidencia sea real.
- Evitar que el sistema muestre explicaciones que parecen convincentes, pero no son causales.
- Manejar casos raros.
- Monitorear drift.
Pero esa complejidad, en una industria donde cada error puede dañar a una persona, es parte de los requisitos.
El aprendizaje para empresas
¿Por qué importa esto si tu empresa no está en salud? Porque el mismo principio se aplica en otras industrias.
- Si estás en retail y quieres predecir demanda, no necesitas pedirle a ChatGPT que “adivine ventas”. Necesitas modelos de forecasting, datos históricos, estacionalidad, inventario y señales externas.
- Si estás en finanzas y quieres detectar fraude, necesitas modelos sobre datos transaccionales, patrones de comportamiento, grafos o anomalías.
- Si estás en logística y quieres optimizar rutas, necesitas optimización matemática, restricciones operativas y datos en tiempo real.
Empieza preguntando: ¿cuál es el problema, cuáles son los datos, cuáles son los riesgos y cómo vamos a medir si funcionó?
Una vez que tienes esto mapeado, elige el tipo de arquitectura que necesitas de acuerdo con el proceso, los datos de entrada y los datos de salida.