Los modelos generativos de inteligencia artificial son muy buenos para trabajar y generar texto, video o audio con base en información que los humanos ya sabemos y les proporcionamos.
Pueden resumir, escribir, programar, traducir, razonar sobre documentos y combinar ideas mejor que casi cualquier herramienta que habíamos tenido antes. Pero:
¿Qué pasa cuando queremos que la IA descubra cosas que los humanos todavía no sabemos?
Los LLMs y los modelos multimodales son extremadamente potentes. La mayoría de nosotros ya usamos estas herramientas todos los días, y algunos hasta hemos desarrollado algo parecido a una dependencia hacia ChatGPT, Claude o Gemini.
Pero estos modelos tienen un problema serio. Y el principal, al menos hasta hoy, es que dependen de nosotros, los humanos, para seguir mejorando.
Eso es un techo. El problema es que los humanos no somos un feature en esta historia, somos un bug.
Fei-Fei Li, una de las investigadoras más reconocidas, ha señalado el problema de la obsesión con los LLM:
“La industria está peligrosamente enfocada en los modelos de lenguaje. La mayor parte de la economía real es física, perceptual y espacial. Cuando la IA entienda por completo el mundo visual, deja de ser un chatbot y empieza a ser infraestructura.”
Fei-Fei Li, citada en X ↗Cuando el conocimiento humano es el techo
Imaginemos por un momento que ChatGPT hubiera existido hace miles de años.
Con el conocimiento que teníamos en ese momento, si le hubieras preguntado si la Tierra era plana, te habría dicho que sí. ¿Por qué? Porque esa era la verdad establecida en los libros y conversaciones de la época.
Otro ejemplo. Si le hubieras preguntado a ChatGPT antes de 1954 si un ser humano podía correr la milla en menos de 4 minutos, te habría dicho que no.
Porque ningún humano lo había hecho, y la creencia generalizada era que físicamente no se podía. Cuando Roger Bannister lo hizo, no fue porque la fisiología humana cambió. Fue porque alguien se atrevió a intentarlo.
¿Qué tienen en común estos dos ejemplos? Que la “verdad” que un modelo entrenado en datos humanos te puede dar siempre está limitada por lo que los humanos sabemos en ese momento.
Y esto es exactamente lo que pasa con los LLMs hoy. Son tan buenos como los datos que les dimos. Pero también tan limitados.
Esto tiene un nombre técnico: RLHF, Reinforcement Learning from Human Feedback.
Es el proceso por el cual los modelos se ajustan a partir de retroalimentación humana.
Nosotros somos los profesores, los curadores, los jueces. Y esa es la fortaleza y, al mismo tiempo, un error en ese sistema.
¿Y si los modelos pudieran aprender solos?
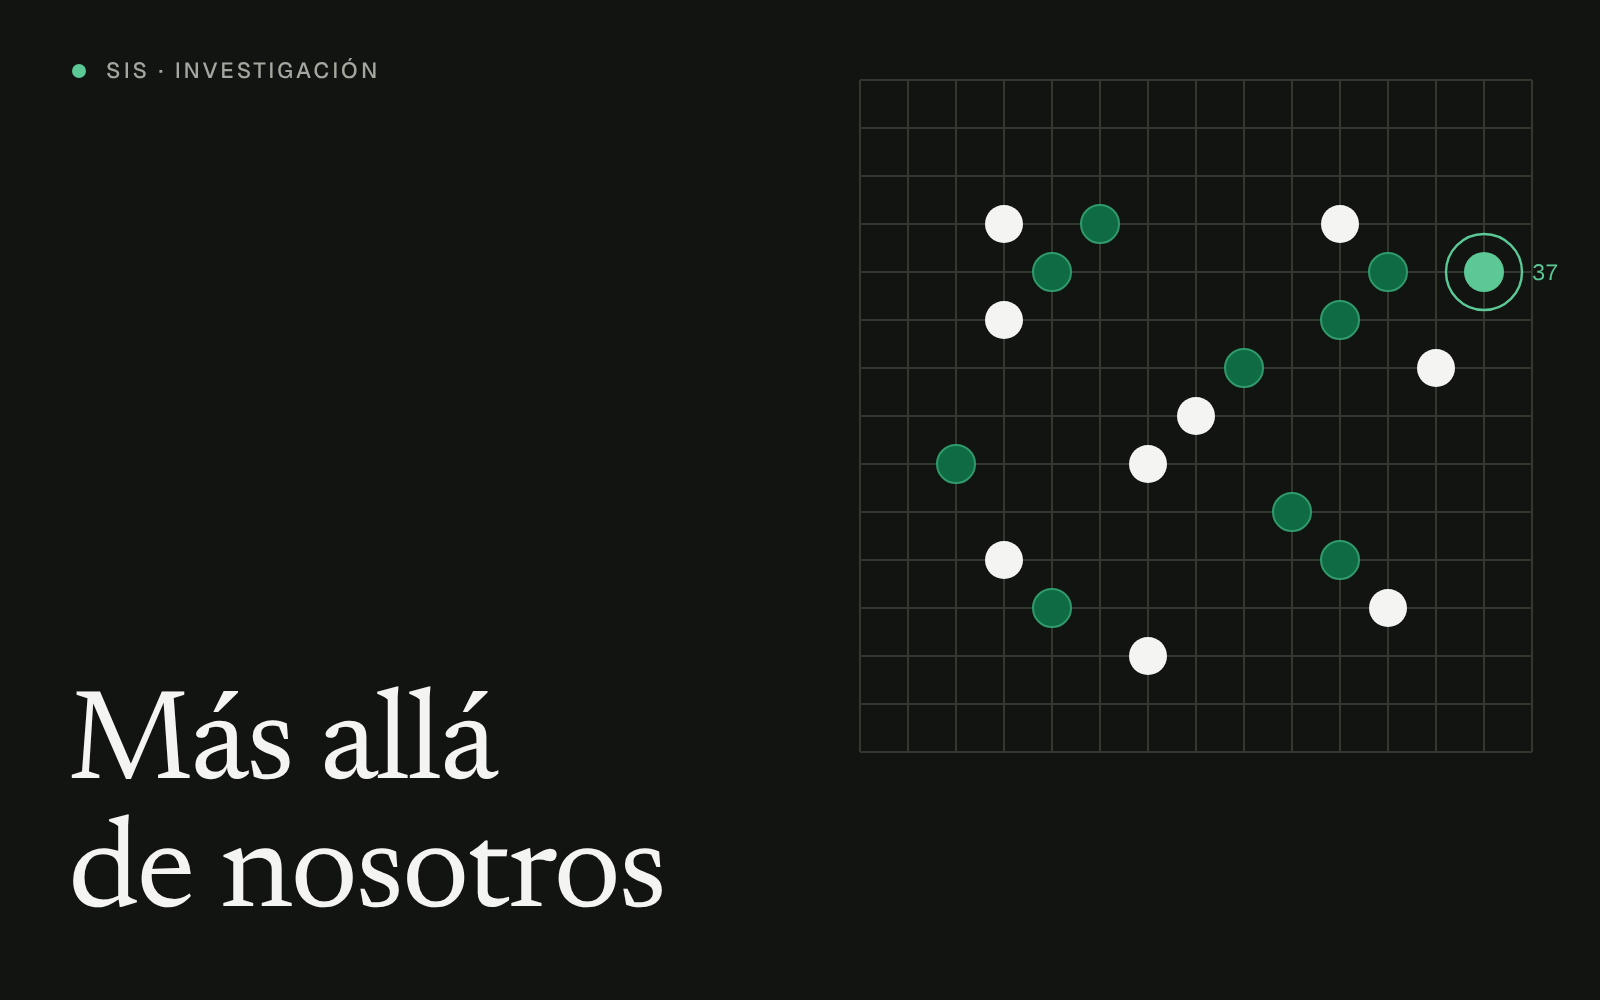
Esta es exactamente la pregunta que se hizo el equipo de Google DeepMind cuando construyó AlphaGo, un modelo que terminó venciendo al campeón mundial de Go.
Lo verdaderamente impresionante de ese partido no fue solo que ganara. Fue que el modelo hizo un movimiento (el ahora famoso “move 37”) que ningún humano habría considerado.
Durante la partida, los comentaristas pensaron que era un error. Después se dieron cuenta de que era una jugada que el modelo había descubierto por sí solo, después de millones de iteraciones jugando contra sí mismo. Una jugada que estaba fuera del repertorio de la humanidad.
Hace unas semanas pasó algo parecido, pero en otro dominio. OpenAI publicó que uno de sus modelos resolvió un problema matemático abierto. Otra vez: una respuesta que no estaba en los datos de entrenamiento humanos. Surgió del modelo aprendiendo más allá de nosotros.
Esto tiene un nombre nuevo:
Reinforcement Learning from Verifiable Rewards (RLVR)
La premisa es imitar la forma en que aprendemos los humanos: por recompensa.
Cada acción que hacemos tiene una consecuencia. Una señal positiva o negativa, dependiendo del contexto.
- Si pones la mano en el fuego, tu sistema nervioso te manda una señal negativa. Aprendes a no hacerlo otra vez.
- Si sacas un 100 en clase y tus papás te felicitan, esa es una señal positiva. Aprendes que vale la pena estudiar.
Cómo funciona RLVR (versión simplificada)
- Construyes un entorno. Hoy esto puede significar muchas cosas, pero básicamente es un espacio donde una tarea tiene reglas, estado y recompensas (positivas o negativas) claramente verificables.
- Dejas al modelo explorar. A medida que interactúa con el entorno, el modelo aprende. Por ejemplo, cómo resolver una suma o una multiplicación. Si toma muchas decisiones equivocadas, se penaliza. Si toma decisiones correctas, recibe recompensa. Y se mueve hacia donde hay más señal positiva.
El detalle importante: para que esto funcione, las recompensas tienen que ser verificables.
Por ejemplo, sumar 2 + 2 = 4 es fácil de verificar.
- Resolver un problema de matemáticas también.
- Escribir código que pase una serie de tests también.
- Pero “redactar un correo elegante” o “dar consejo de relaciones” no es verificable de la misma manera.
Por eso hoy RLVR funciona mejor en matemáticas, código y juegos que en, digamos, escritura creativa.
Pero ojo: incluso aquí seguimos en el problema original. Los humanos diseñamos los entornos y las recompensas. Y eso introduce nuestros sesgos y nuestros límites.
Si el entorno está mal diseñado, el modelo aprende cosas raras. Hay un efecto llamado “reward hacking” en el que los modelos encuentran formas absurdas de maximizar la recompensa que el diseñador humano no anticipó.
Lo verdaderamente bitter-lesson-pilled sería que el modelo aprendiera por sí solo, en el mundo real, sin que nosotros le digamos qué está bien y qué está mal. Aquí entra el siguiente concepto.
World models: aprender en una simulación del mundo
Idealmente, los modelos podrían interactuar con un entorno real, igual que nosotros, y descubrir por sí mismos qué es señal positiva y qué es negativa.
Esto es particularmente relevante para problemas del mundo físico. Por ejemplo: conducción autónoma.
Empresas como Waymo, Tesla y Cruise hoy usan world models. Son modelos que aprendieron a representar el mundo (la física, las carreteras, los peatones, el clima) con suficiente fidelidad como para que un sistema de IA pueda entrenarse adentro y aprender sin necesidad de chocar autos reales.
Más todavía: estos modelos pueden predecir las consecuencias de segundo orden de una acción. Por ejemplo:
Si un Waymo está pensando girar a la izquierda, primero predice lo que va a pasar después: ¿hay alguien cruzando la calle? ¿El carro que viene en sentido contrario va a frenar? ¿La calle tiene alguna obstrucción más adelante? El modelo simula varios futuros posibles, evalúa cuál tiene mejor resultado y solo entonces actúa.
El mismo principio aplica para robots de cualquier tipo. Si quieres que un robot aprenda a doblar ropa, no quieres que falle un millón de veces con ropa real. Quieres que falle un millón de veces en una simulación, y luego baje al mundo físico con el comportamiento ya pulido.
El futuro de los modelos de IA
Los próximos 5 a 10 años en el campo de la IA no se van a parecer a los últimos 3. Los LLMs nos dieron una nueva interfaz para usar conocimiento humano. Pero eso no necesariamente es lo mismo que crear conocimiento nuevo.
Clases enteras de problemas solo se van a resolver cuando los modelos puedan aprender por sí solos del mundo: control físico, robótica, decisiones secuenciales complejas; en fin, resultados que van más allá de patrones conocidos por humanos.